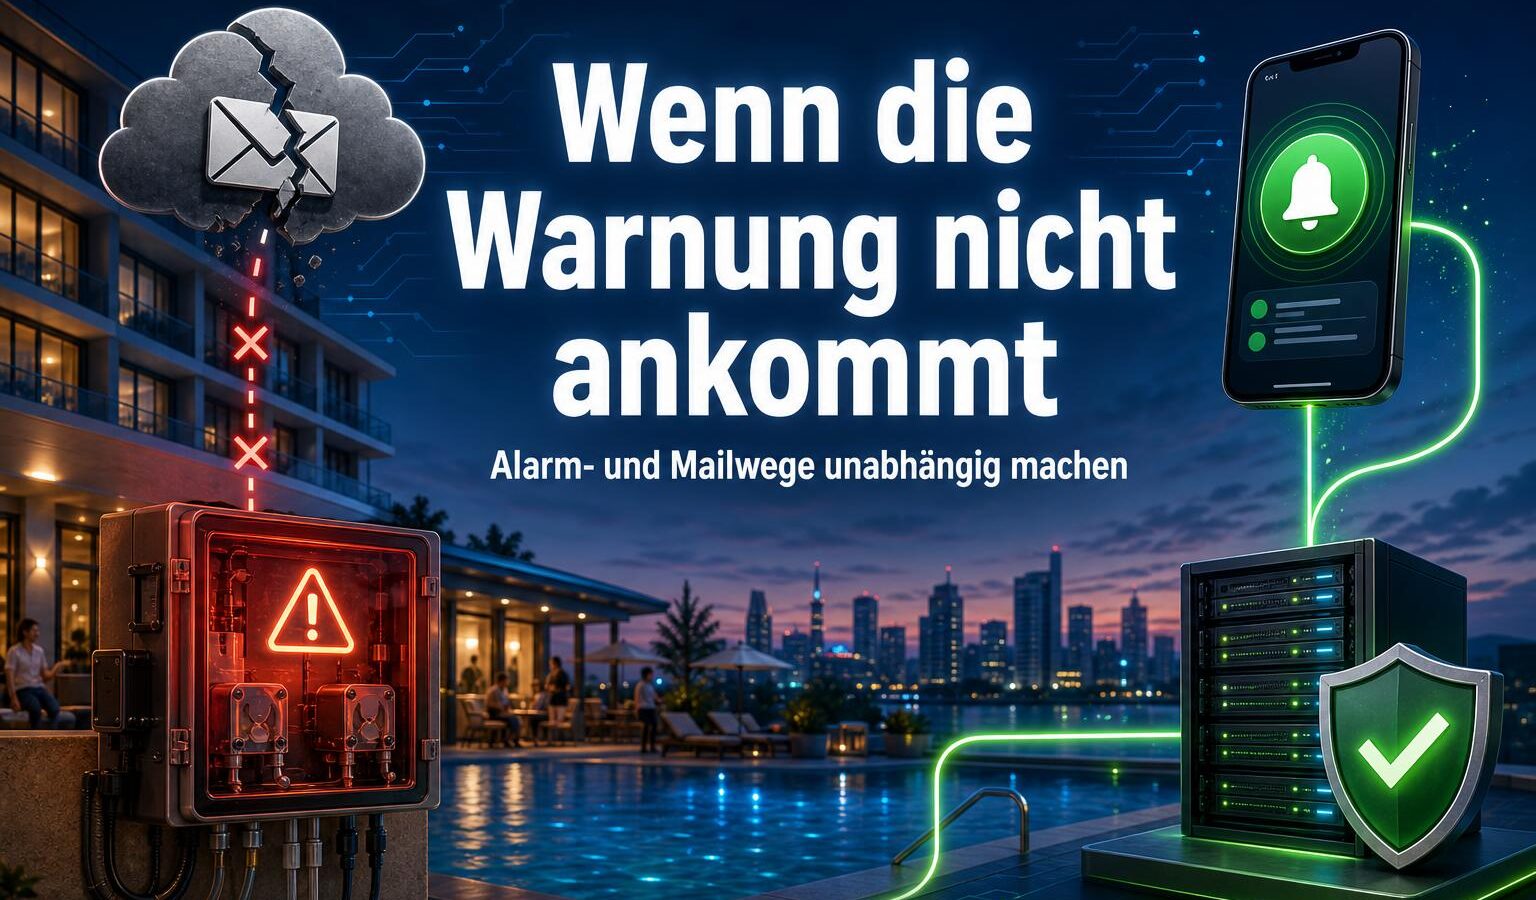
Eine defekte Chlorpumpe in einem Hotel und ein Fehler in Microsofts Rechenzentren – zwei Dinge, die eigentlich nichts miteinander zu tun haben. Am Freitag, dem 13. November 2026, kamen sie im Hotel Ling Bao des Phantasialands in Brühl bei Köln zusammen. Eine automatische Dosieranlage gab zu viel Chlor in den Hotelpool. Die Überwachung erkannte das und schickte eine Warnung los – per E-Mail. Diese Mail kam nach übereinstimmenden Berichten nicht an, weil Microsofts E-Mail-Dienst zu diesem Zeitpunkt weltweit gestört war. 15 Gäste wurden verletzt, vier kamen ins Krankenhaus.
Wichtig ist die Einordnung: Microsoft hat die Chloranlage nicht gesteuert, der Defekt entstand vor Ort. Ob es weitere Alarmwege gab und warum die Anlage nicht selbst abschaltete, ist noch offen. Trotzdem zeigt der Fall so deutlich wie selten, wie weit die Folgen eines Cloud-Ausfalls reichen können – und warum sich jedes Unternehmen fragen sollte, was bei ihm alles an einem einzigen Dienst hängt.
Was bei Microsoft schiefging
Inzwischen hat Microsoft einen vorläufigen Untersuchungsbericht vorgelegt. Danach dauerte die Störung von Donnerstag, 12. November, 17:20 Uhr deutscher Zeit bis Freitagnachmittag – knapp 24 Stunden. Einen Cyberangriff schließt Microsoft aus. Stattdessen kam eine ganze Kette von Problemen zusammen:
- Ein schlafender Fehler: In einer Korrektur für die Netzwerk-Gateways, die seit Juli ausgerollt war, steckte ein Softwarefehler. Monatelang fiel er nicht auf, weil er nur unter einer bestimmten Last auftritt – und weil die Testsysteme schwächere Hardware hatten als der Echtbetrieb.
- Weniger Reserve: Durch einen anderen Vorfall am Vortag fehlten rund 14 Prozent der Gateway-Kapazität.
- Mehr Last: Im normalen Betrieb wurde zusätzlicher Datenverkehr von Teams auf genau diese Gateways verlagert.
- Die Kettenreaktion: Die ersten Server liefen voll. Die automatische Umleitung, die eigentlich Ausfälle verhindern soll, schob die Last auf die übrigen Server – bis zeitweise mehr als 80 Prozent nicht mehr erreichbar waren. Die Trennwände zwischen den Regionen griffen wegen eines weiteren Problems nicht, die Störung breitete sich weltweit aus.
Andere Dienste wie Teams oder SharePoint konnten auf andere Wege ausweichen. Exchange Online, also die E-Mail, konnte das nicht. Selbst wiederhergestellte Server wurden sofort wieder von wartenden Anfragen überrollt, sodass Microsoft die Infrastruktur Stück für Stück neu aufbauen musste. Über den Ausfall selbst haben wir bereits hier berichtet.
Wie abhängig sind wir inzwischen?
Der Fall Phantasialand ist extrem, das Grundproblem ist alltäglich. Laut einer repräsentativen Bitkom-Umfrage unter 603 Unternehmen müssten 46 Prozent früher oder später ihren Geschäftsbetrieb einstellen, wenn ihre Cloud-Dienste ausfallen – 9 Prozent sogar sofort. Im Schnitt halten Cloud-Nutzer rund drei Tage durch. Nur 8 Prozent setzen auf einen zweiten Cloud-Anbieter, nur gut ein Drittel auf redundante Systeme.
Und es trifft nicht nur die Unternehmen selbst. Wenn eine Behörde, eine Arztpraxis oder ein Dienstleister keine Mails bearbeiten kann, merken das auch alle, die gar kein Microsoft 365 nutzen.
Die Cloud ist nicht das Problem – ein einziger Weg schon
Man muss fair bleiben: Ein großer Anbieter betreibt seine Systeme meist zuverlässiger, als es ein kleines Unternehmen nebenher könnte. Eigene Server müssen gewartet, aktualisiert und abgesichert werden, man braucht Backups, Spamfilter und einen Notfallplan. Das Problem entsteht dort, wo alles an einem Anbieter hängt: E-Mail, Kalender, Videokonferenz, Dateien und oft auch die Anmeldung. Bequem, solange alles läuft. Fällt aber eine zentrale Komponente aus, steht plötzlich alles still – oder eine Warnung kommt nicht an, die dringend hätte ankommen müssen.
Vier Lehren aus dem Fall
- Kritische Warnungen brauchen mehr als einen Weg. Eine E-Mail kann verspätet oder gar nicht ankommen. Wo es um Sicherheit geht, gehören eine lokale Warnanlage, ein Anruf, eine SMS oder eine Push-Benachrichtigung über einen technisch unabhängigen Dienst dazu.
- Sicherheitstechnik muss auch offline sicher sein. Eine Anlage sollte bei gefährlichen Werten selbst in einen sicheren Zustand gehen – eine Warnmail darf nie die einzige Schutzmaßnahme sein.
- Ausfälle gehören in die Planung. Was passiert, wenn E-Mail und Teams einen Tag lang nicht gehen? Sind wichtige Nummern offline greifbar? Laufen die entscheidenden Abläufe weiter? Diese Fragen beantwortet man am besten vorher.
- Abhängigkeit von einem Anbieter verringern. Schleswig-Holstein zeigt, dass es geht: Nach Angaben des Landes arbeiten fast 80 Prozent der Arbeitsplätze außerhalb der Steuerverwaltung mit LibreOffice, knapp 44.000 Postfächer laufen auf einer offenen Lösung, und das Land spart mehr als 15 Millionen Euro an Lizenzen – bei einmaligen Umstellungskosten von 9 Millionen Euro.
Unabhängiger mit offenen Bausteinen
Genau hier setzen wir an. Statt alles in ein Paket zu stecken, verteilen wir die wichtigsten Aufgaben auf bewährte, offene Systeme, die unabhängig voneinander laufen:
- E-Mail mit mailcow: ein vollständiger Mailserver mit Webmail, Kalender, Kontakten, Spam- und Virenfilter. Outlook, Thunderbird und Smartphones funktionieren wie gewohnt.
- Dateien und Zusammenarbeit mit Nextcloud: gemeinsame Ablage, Kalender, Dokumente im Browser und mit Nextcloud Talk auch Chat und Videotelefonie.
- Videokonferenzen mit Jitsi Meet: Besprechungen direkt im Browser, ohne Konto und ohne Installation für die Teilnehmer.
- Alarme mit eigenem Push-Dienst: Selbst gehostete Benachrichtigungsdienste wie ntfy schicken Warnungen von Anlagen, Servern oder Überwachung direkt aufs Smartphone – unabhängig von jedem E-Mail-Anbieter.
- Netz und Fernzugriff mit OPNsense: eine Firewall, die Technik sauber trennt und Zugriffe nur per VPN erlaubt.
Natürlich ist auch Open Source keine Garantie gegen Ausfälle, und auch ein eigener Server kann einmal stehen. Der Unterschied: Die Systeme hängen nicht aneinander, du bist nicht einer von Millionen in der Warteschlange, und du weißt, was passiert ist. Und um Wartung, Updates, Backups und Spamfilter musst du dich nicht selbst kümmern – das übernehmen wir, gehostet in Deutschland.
Fazit
Ein defekter Chlordosierer und eine Microsoft-Störung – zwei getrennte Probleme, die zusammen Menschen verletzt haben. Der Fall zeigt, wie viel heute an wenigen großen Diensten hängt. Ausfälle wird es immer geben. Entscheidend ist, ob dann eine wichtige Warnung trotzdem ankommt und ob dein Betrieb weiterarbeiten kann. Mit getrennten, offenen Systemen wie mailcow, Nextcloud und Jitsi und einem unabhängigen Alarmweg bist du darauf deutlich besser vorbereitet.
So unterstützen wir dich
Wir machen deine Kommunikation unabhängiger und ausfallsicherer – ohne dass du dafür eine eigene IT-Abteilung brauchst:
- mailcow als eigener Mailserver, eingerichtet und betreut, inklusive Umzug von Exchange Online
- Nextcloud mit Talk und Jitsi Meet für Dateien, Kalender und Besprechungen
- Unabhängige Alarmwege für Anlagen und Server, etwa per Push-Benachrichtigung
- Notfallplan für den Fall, dass ein Dienst ausfällt
- Hosting in Deutschland mit Updates, Backups und Monitoring – und einem festen Ansprechpartner
Lass uns gemeinsam prüfen, was bei dir an einem einzigen Anbieter hängt – und wie du das änderst.
Du willst das in deinem Unternehmen umsetzen oder hast Fragen dazu? Schreib uns, ruf an unter +49 6026 9498635 oder nutze das Anfrageformular – das Erstgespräch ist kostenlos.